当全世界都在比拼谁的模型更大,真正的智者会问另一个问题:这件事的核心规律,究竟需要多少行代码就能表达?
2024年,谷歌DeepMind的AlphaFold3摘得诺贝尔化学奖。评委的一句话意味深长:“
它用极小的数据集,解决了一个纠缠人类五十年的大问题。”AlphaFold的核心训练集不过十几万条蛋白质序列——比起大语言模型动辄万亿token的语料,简直微不足道。但它却做到了从氨基酸序列直接预测蛋白质三维结构,把蛋白折叠结构预测精度推到原子级别。
两年后,Keras之父弗朗索瓦·肖莱发布了ARC-AGI-3基准测试。全球最强的GPT-5被扔进一堆连规则说明书都没有的网格推理游戏里,得分0.7%。人,满分。人类用10步完成的任务,AI用了224步。
一边是十几万条数据撼动生物学根基。一边是一万亿参数换不回一个幼儿的推理能力。
这不是两个AI的故事。这是两条AI道路的终局预演。
AlphaFold凭什么“四两拨千斤”?
蛋白质折叠被称作“生物学圣杯”。一条氨基酸链在细胞里能自发折叠成特定三维形状,“形状决定功能”——错了,就是阿尔茨海默症、帕金森症。理论上,一条蛋白质的可能折叠方式数量超过宇宙年龄的秒数。但在细胞里,这个过程只需几毫秒。这就是著名的“莱文塔尔悖论”。
五十年来,科学家用冷冻电镜等方法一个个“测绘”蛋白质结构,耗资数十亿美元,覆盖了不到20万种——而自然界中尚未解析的数不胜数。
DeepMind团队走了另一条路。他们没有去堆砌算力,而是回到了问题的物理本质:蛋白质折叠的规律,早已埋在进化史中。他们从公开数据库收集了约17万条蛋白质序列和对应结构,
训练了一个深度学习系统。这个系统学会的不是“背诵蛋白质的长相”,而是氨基酸之间的几何关系——哪些倾向于肩并肩,哪些倾向于面对面。
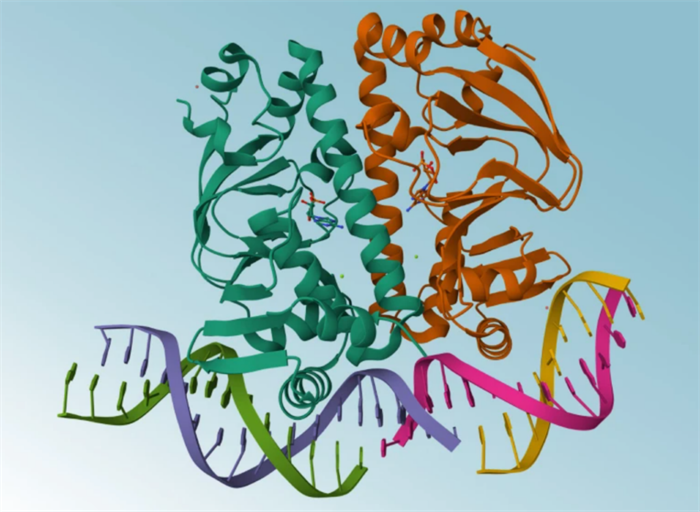
2020年,AlphaFold2在CASP14竞赛中以GDT中位数92.4分震惊计算生物学界。这个分数意味着它的预测与实验结构几乎完全重叠。CASP联合创始人约翰·穆尔特说:“从某种意义上说,问题已经解决了。”
AlphaFold的泛化能力惊人——训练集里从未出现过的蛋白质,它同样能精确预测。
这就是“小数据智能”的威力:不是把全世界的蛋白质都看一遍,而是从有限样本中提炼出折叠的物理定律。
一万亿参数的幻灭
与AlphaFold形成残酷对比的,是大语言模型的路线困境。
肖莱在2019年就设计了ARC基准测试,专门测量一种被他称为“
流体智能”的能力——
面对从未见过的新问题,能够当场理解、当场推理、当场解决。与之相对的是“记忆化技能”:依靠海量训练数据中见过的模式来应付考试。
他的批评直指万亿美金投入的根本方向:
大语言模型的本质是什么?是高维空间中的曲线拟合。它用数百层Transformer网络,将训练语料中每一个“语义模式”编码为参数空间中的一个曲面。你提问,它在曲面上找最近的点进行“插值”。这意味着它极其擅长在你问过的东西附近给出答案——但如果你的问题落在从未见过的盲区,它连粗糙的猜测都做不出来,因为它从不知道“规则”是什么。
ARC-AGI-3击穿了四个盲区:主动探索、世界建模、自主目标设定、规划中的动态修正。肖莱说,GPT从GPT-2到GPT-4.5,规模扩大约五万倍,ARC得分几乎纹丝不动。最令人深思的是,拿下36.08%最高分的Symbolica方案,并非依靠单一巨型大模型,而是用组合推理完成。
一个或许令人不安的结论浮出水面:
在生物演化赋予人类的“举一反三”面前,一万亿参数只是一堆昂贵的沉默。
DeepSeek的启示:效率是一种信仰
在一片弥漫着算力焦灼的迷雾中,2026年4月放出V4预览版的DeepSeek,走出了一条值得造船业从业者凝视的道路。
DeepSeek V4的策略不是追求参数绝对领先,而是“
效率与智能的平衡”。旗舰版总参数1.6万亿,单次推理只激活490亿;经济版总参数2840亿,激活仅130亿。最惊人的是长文本效率:百万token上下文下,每token算力消耗只有前代V3.2的27%,KV缓存占用仅10%。当GPT-5.5百万输出token定价30美元时,DeepSeek V4-Flash定价折合不到0.3美元——成本差逾99%。
这背后的技术逻辑与AlphaFold惊人一致:
不再奢求把全世界知识装进一个模型,而是通过原创架构设计让模型学会“什么重要,什么可略过”。它不是完美方案,但至少在万亿参数军备竞赛烧得最旺的时代,证明了“
用更少代价做出同样好的东西”并非妄念。
对船舶工业的启示
1992年,物理学家戴维·多伊奇写道:“
智能不是知识的数量,而是从少量知识中快速推导出大量正确结论的能力。”肖莱给出了简极的数学定义:智能 = 学习速度。不是你已学会多少任务,而是面对全新任务,你需要多少个样本来掌握。
这对船舶工业意味着什么?
造船业从来不是一个追逐宏大叙事的行业。一艘LNG船价值数亿美元,设计寿命40年,任何一个环节失误都可能带来灾难性后果。
AlphaFold的哲学告诉我们:
造船业的核心智能,不在于把全世界的船舶数据都塞进一个模型,而在于能否从有限的高质量工程数据中提炼出物理规律。我们面对的真正挑战,不是“数据不够多”,而是“数据不够懂”——设计部门的BOM变更、生产部门的工时进度、采购部门的物料到货情况,往往散落在互不联通的系统中。与其花天价算力去“暴力学习”,不如先下力气打通数据孤岛,用高质量的结构化数据去训练能发现规律的“小模型”。
大语言模型的教训告诉我们:一个能流畅写出船舶设计论文的AI,不代表它真正懂得焊接。
真正有价值的方向,是把AI深度嵌入具体业务流程——读懂焊缝X光片的AI视觉、预判发动机故障的振动分析算法、实时优化航线能效的数字孪生系统。这些“沾满泥土的真实场景”,才是护城河所在。
DeepSeek的路线告诉我们:
在资源有限的前提下,架构创新比参数堆砌更重要。船舶工业的AI之路,不必去与人比谁的模型大,而是应当追求“精准”与“效率”的平衡——用更智能的算法架构,解决更具体的工程问题。
技术的尽头,从来不是“更大”,而是“更懂”。当全世界都在比拼谁能堆出更高的参数,造船业应温故知新:一座水坝,不该只用来浇一朵花。真正有力量的,是看见花朵需要多少水,就取多少水——不多,也不少。(供稿:陈建榕)